数据隐私
本地数据脱敏工作台
面向审计资料的本地数据保护工作台,将混合检测、人工复核、原页 PDF 遮罩与可选 C++ 内核接入脱敏流程。
- 项目范围
- CLI + Windows 桌面应用
- 当前状态
- 已完成
- 我的角色
- 独立开发者
技术栈
- Python
- Polars
- PyQt5
- C++
- Tesseract
- 确定性伪名化
项目解决什么
审计资料往往同时包含表格、JSON、邮件、PDF 和 Word,人工处理既容易遗漏,也难以让同一个人或员工标识在不同文件中保持可追踪的替身。ITA-Maskit 把规则选择、命中预览、本地处理和版本化审计记录串成一条工作流,让敏感值离开原始文件后仍能保留必要的关联关系。
核心功能
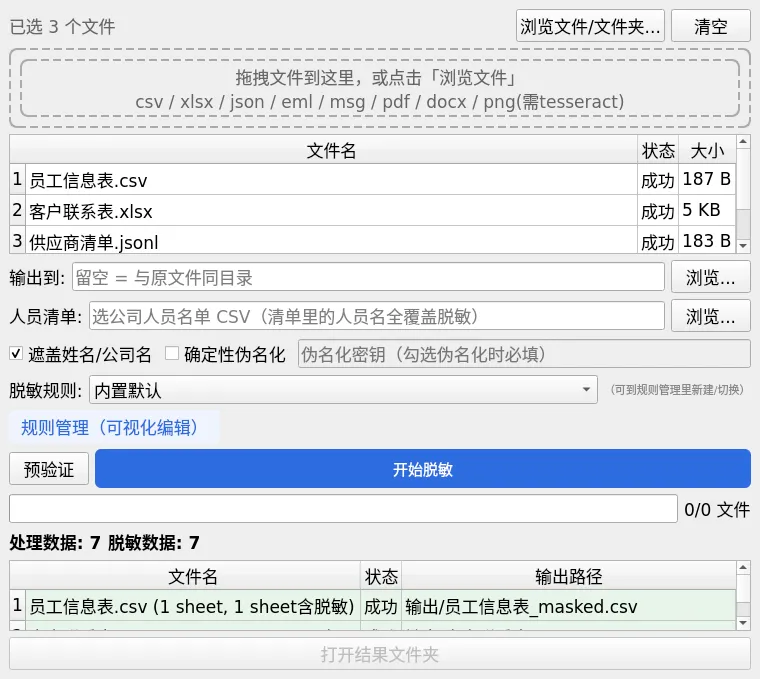
- 通过 CLI 或 Windows GUI 选择规则并批量处理
- 在本地处理表格、JSON、邮件、PDF 和 Word
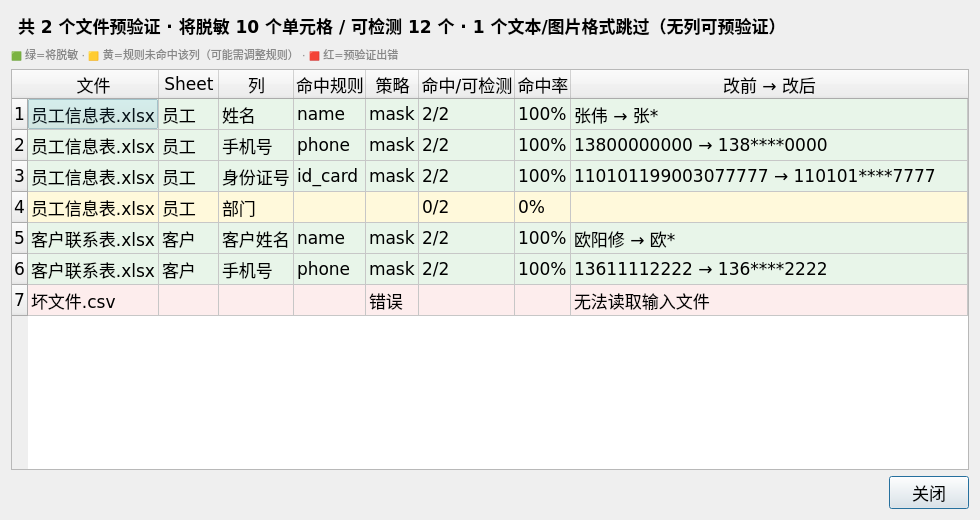
- 正式写出前预览规则命中与样例变化
- 选择遮盖或确定性伪名化
- 使用人员清单补足姓名与员工标识匹配
- 查看统计、输出位置和版本化审计日志
使用流程
- 选择文件、规则集和可选人员数据
- 预验证命中而不写出结果
- 在本地执行遮盖或确定性伪名化
- 查看统计、输出路径和审计日志
使用者可以通过 CLI 或 Windows GUI 选择文件、规则集和人员清单。系统先预览规则命中与样例变化,确认后才在本地批量写出结果;统计、输出位置和版本化审计日志留在同一条处理边界内。
项目亮点
用双引擎覆盖表格与文档
按列处理的表格引擎覆盖 CSV、Excel 与 JSON/JSONL;全文文档引擎处理邮件、PDF 和 Word。检测分为列名匹配、整格强特征检测和格内/全文扫描,电话、工号等弱特征需要配置或上下文,减少普通数字被误伤。
8 月更新加入 PDF 原页遮罩:数字原生页用文字坐标定位,扫描页用本地 Tesseract OCR 定位,在保留页面尺寸的前提下遮罩并回扫;回扫仍检出已检测原文时移除输出。图片裁剪脱敏仍是独立的 beta 路径,不能与扫描 PDF 原页遮罩混为一谈。
把脱敏规则变成可维护的数据
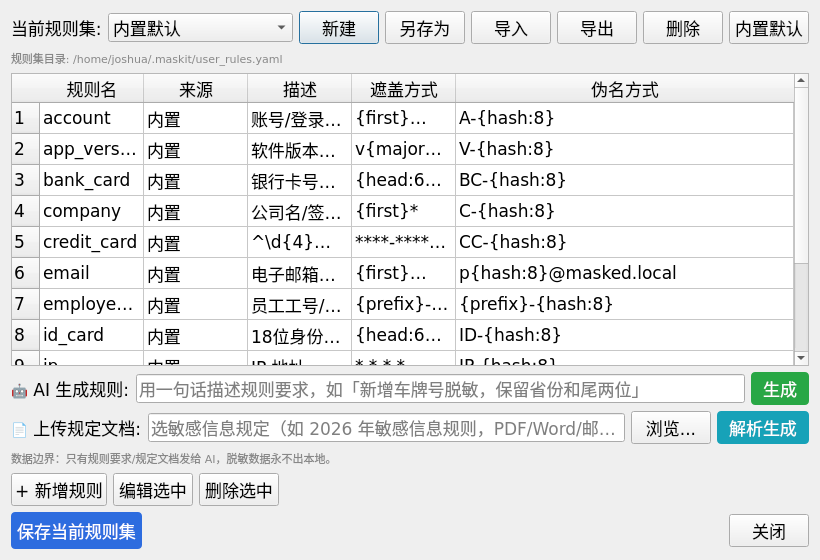
规则以 YAML 保存字段映射、匹配策略、遮盖模板和伪名化模板,并把规则版本与处理代码分开。业务规则变化时只需更新经过校验的数据配置;预览和正式执行复用同一版本,减少规则漂移。
证件号或银行卡校验失败时,可选择 review 模式交由人工复核;strict 模式在仍有未处理事项时不保留最终输出。复核记录默认只含指纹与遮盖预览。可选 LLM 规则生成只发送用户提供的规则描述或规则文档,待脱敏文件不进入该调用。
保留跨文件关联而不暴露原值
系统先按字段策略归一化输入,再使用用户提供的 pepper 做域分离的 HMAC。相同的归一化值在不同文件中会得到稳定的确定性别名,人员清单还可以补足姓名和员工标识的匹配;原始值不会作为别名暴露,pepper 也只停留在运行配置中。
可选 C++ 内核加速 HMAC、人员清单 Trie 与校验,完整 Python 路径仍可独立使用。仓库报告的约 3× HMAC 与 26× Trie 提升是对应内核基准,不是整表端到端加速;gold/stress 合成集的 F1=1.0 也不等于真实审计资料零漏检。
系统架构
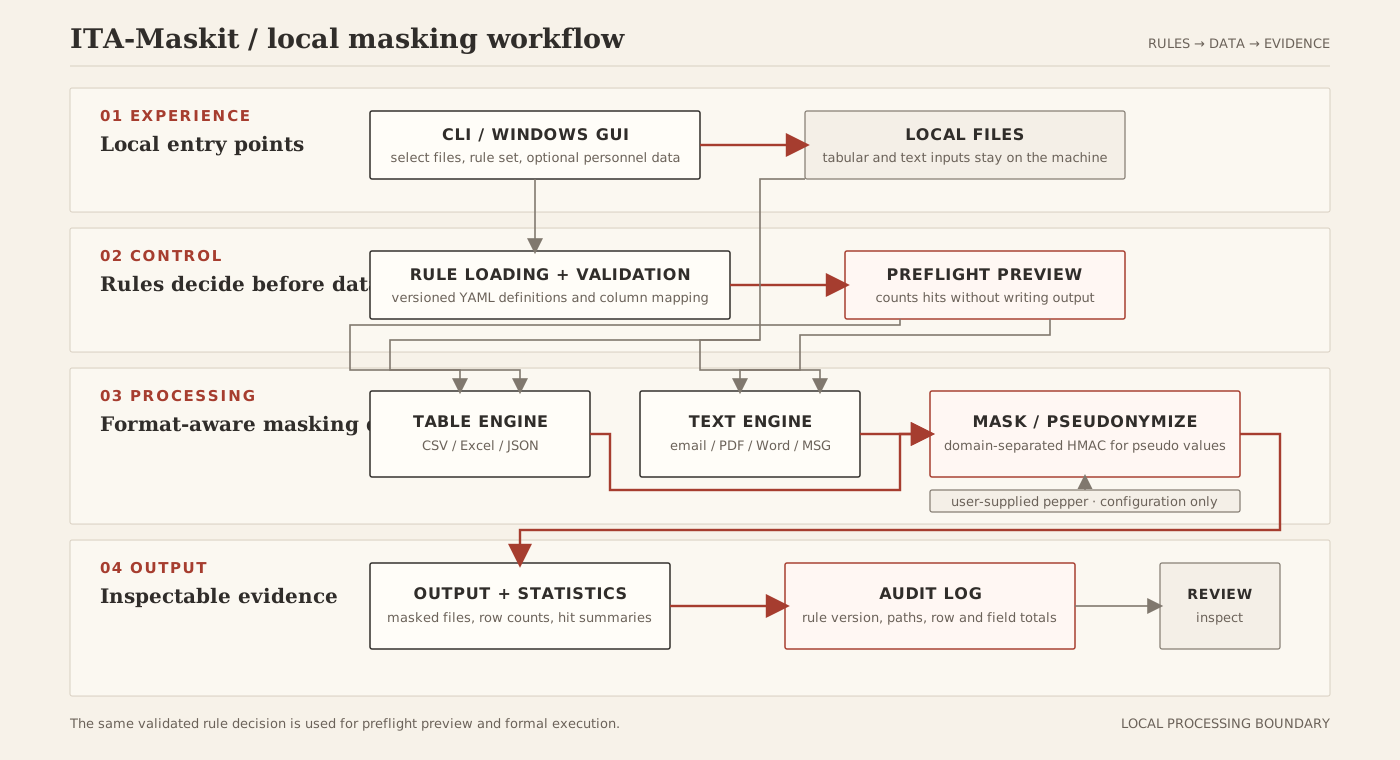
同一版本的规则先驱动预览,再分别进入按列的表格引擎或全文的文档引擎。遮盖或确定性伪名化完成后,系统输出处理结果、统计和版本化审计日志;整个过程不需要把审计文件发送到外部服务。
项目边界
这是一个面向审计资料的本地处理工具,不宣称通过认证或替代部署环境中的访问控制、密钥管理与加密存储;截图使用仓库的脚本演示数据。确定性伪名化不是加密,图片裁剪仍处于 beta;PDF 回扫只验证已检测的原文,不能证明整份文件无敏感信息。扫描页需要本机 OCR,PyMuPDF 的许可与分发条件需独立评估。